L'IA dans la simulation de flux
L’intelligence artificielle ne remplace pas un modèle de simulation, mais elle en accélère l’exploration, en améliore le calage et en élargit la lecture des résultats. Cinq apports se distinguent : les modèles de substitution, la calibration des paramètres, l’optimisation, l’analyse des scénarios et des données, et un cadre de limites et de bonnes pratiques.
Vue d’ensemble
| Apport | Ce que l’IA apporte | Conséquence pratique |
|---|---|---|
| Modèles de substitution | Un modèle d’approximation entraîné sur des entrées-sorties du simulateur | Explorer un grand nombre de scénarios sans relancer la simulation |
| Calibration | Retrouver les paramètres qui rendent le modèle cohérent avec les mesures | Un modèle calé sur l’observé, avec une incertitude quantifiée |
| Optimisation | Chercher les configurations qui atteignent un objectif | Passer de « que se passe-t-il si ? » à « quelle règle atteint la cible ? » |
| Analyse des données | Classer, expliquer et résumer des jeux de sorties volumineux | Des conclusions lisibles sur des volumes que la lecture directe n’absorbe plus |
| Limites et bonnes pratiques | Un cadre pour contrôler la fiabilité de chaque usage | L’IA reste un outil audité, pas une boîte noire |
Modèles de substitution : explorer sans relancer la simulation
Le machine learning appliqué à la simulation consiste à entraîner un modèle de substitution — réseau de neurones, forêt aléatoire, processus gaussien — sur les sorties d’un simulateur. La démarche est documentée pour les modèles de simulation à événements discrets : on échantillonne l’espace des paramètres, on exécute le modèle sur cet échantillon, puis on apprend le métamodèle.
Le plan d’expériences organise ce flux, du modèle de référence jusqu’à l’exploration accélérée :
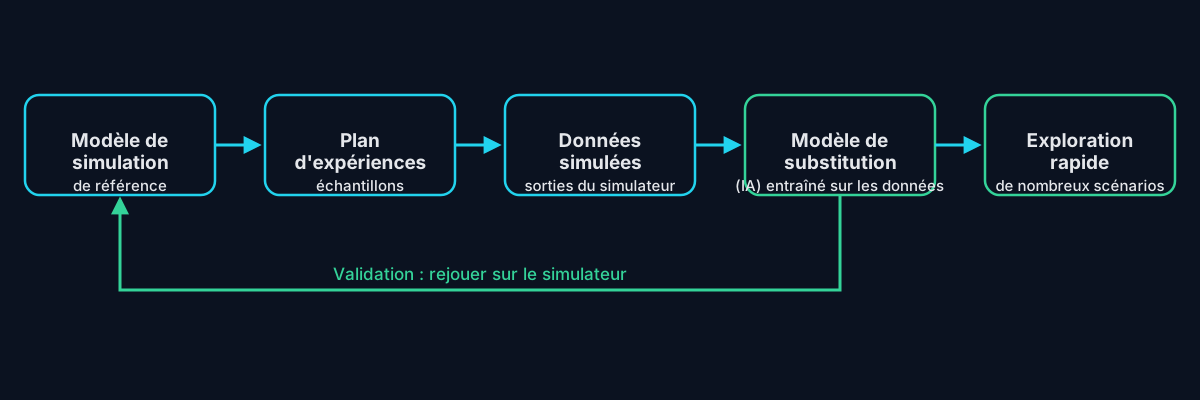
Métamodélisation : le modèle de substitution est entraîné sur des données simulées, puis validé en relançant le simulateur.
Le gain de vitesse est l’argument principal. Dans un exemple publié sur un flux de batteries à événements discrets, chaque exécution du modèle durait environ dix minutes ; le métamodèle l’a ramenée à une fraction de seconde. Cette accélération rend praticables des explorations qui ne l’étaient pas.
Le métamodèle n’est pas une copie du simulateur. Son erreur se mesure sur des points non vus pendant l’entraînement et reste plus élevée sur les sorties rares ou très variables. Il complète la simulation, sans la remplacer.
Calibration et ajustement des paramètres
Quand une entrée du modèle est inconnue — temps de réglage réel d’une machine, taux de rebut, durée d’une absence non programmée — les sorties observées permettent parfois de la retrouver. C’est le problème inverse, traité en détail dans la page caler les paramètres par machine learning : échantillonner l’espace des paramètres, simuler, entraîner un métamodèle, puis chercher les paramètres dont les sorties prédites se rapprochent le plus des mesures. La calibration de modèle s’apparente à cette recherche de cohérence entre modèle et observations.
La boucle se lit comme un cycle : confronter les sorties aux mesures, mesurer l’écart, ajuster les paramètres, re-simuler.
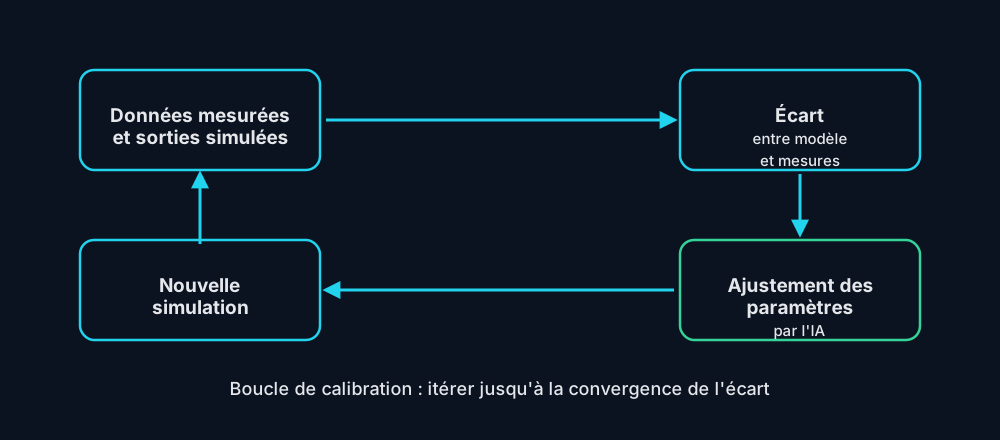
Boucle de calibration : l’écart entre le modèle et les mesures guide l’ajustement des paramètres par l’IA.
Une réserve s’impose : un même indicateur moyen peut s’expliquer par plusieurs combinaisons de paramètres. Le résultat de la calibration est une estimation assortie d’une incertitude à quantifier — par intervalle de vraisemblance, ré-échantillonnage ou inférence bayésienne. Et un paramètre sans effet sur les sorties mesurées ne peut être retrouvé par aucune méthode : une analyse de sensibilité préalable le détecte.
Optimisation : chercher une configuration cible
La simulation répond classiquement à des questions « que se passe-t-il si ? ». L’optimisation couplée à un métamodèle inverse la question : quel nombre de ressources, quelle règle de priorité, quel seuil de déclenchement atteignent un objectif — réduire le temps de séjour, le coût ou le taux de dépassement d’un seuil — sous des contraintes explicites ? L’optimisation s’appuie alors sur le métamodèle pour parcourir l’espace des configurations et ne relancer la simulation que sur les candidats prometteurs ; l’apprentissage actif oriente les exécutions suivantes vers les zones les plus informatives de cet espace.
Le cycle alterne proposition et évaluation jusqu’à la configuration retenue :
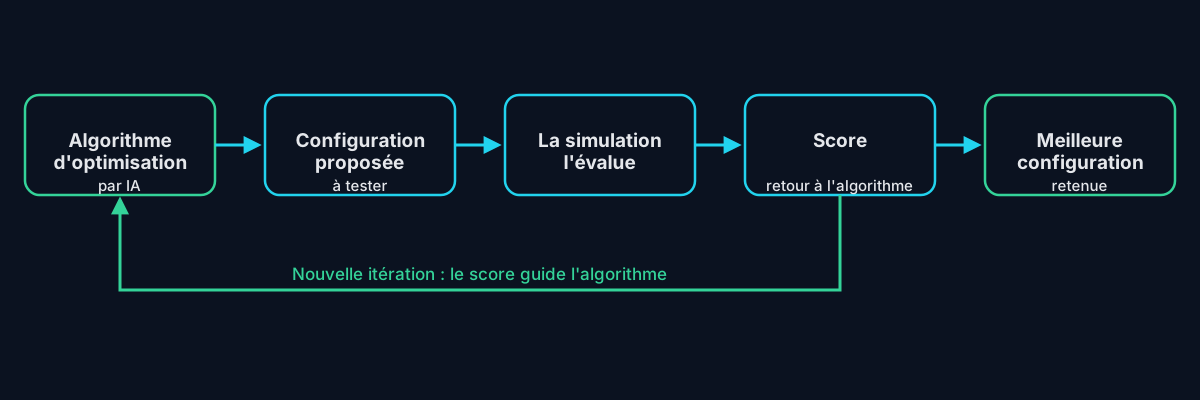
Optimisation : la simulation évalue chaque configuration proposée par l’IA jusqu’à la meilleure configuration retenue.
Le résultat d’une optimisation n’est accepté qu’après contrôle : la configuration retenue est rejouée sur le simulateur de référence, et l’écart avec les prédictions du métamodèle est publié avec la conclusion, comme le préconise une bonne pratique de vérification et validation.
Analyse des scénarios et des données
Un plan d’expériences produit des tables de sorties trop volumineuses pour une lecture ligne à ligne. L’IA aide à les exploiter :
- Classer les paramètres influents par analyse de sensibilité globale, pour vérifier que ce qui pèse sur la conclusion a bien été mesuré.
- Regrouper les scénarios aux comportements proches, pour ne présenter au décideur que quelques familles au lieu de centaines de courbes.
- Signaler les régimes inhabituels — combinaisons extrêmes, montées en charge, valeurs aberrantes — que la moyenne lisse.
- Résumer les sorties en indicateurs lisibles, sans supprimer l’incertitude associée.
L’usage à grande échelle est illustré par la fiche machine learning et énergie de datacenter : les sorties simulées d’un système énergétique sont prédites, classées et comparées à une baseline, jusqu’à rendre possible le pilotage en continu de consignes réelles.
Limites et bonnes pratiques
Quatre limites. L’IA hérite des approximations du modèle : un métamodèle entraîné sur un modèle biaisé produit des prédictions précises et fausses, et les biais d’une simulation de flux s’appliquent intégralement. Son erreur ne se contrôle que sur des données non vues : hors du domaine couvert par le plan d’expériences, elle n’est pas connue. Elle ne dispense pas de la vérification et validation du modèle sous-jacent, qui restent des travaux distincts. Elle vieillit : quand le système réel change — gamme, effectifs, saisonnalité — le métamodèle et la simulation se périments ensemble.
Bonnes pratiques. Une checklist à tenir pour chaque usage de l’IA :
- Réserver un jeu de données non utilisé pour l’entraînement, afin de mesurer l’erreur du métamodèle.
- Documenter le plan d’expériences, les lois d’entrée et le nombre de réplications qui alimentent l’apprentissage.
- Ne pas interroger le métamodèle hors des bornes du plan d’expériences.
- Garder le simulateur comme référence et rejouer sur lui tout résultat d’optimisation avant de le présenter.
- Dater le métamodèle et sa version, et le re-entraîner quand le système change, comme on révise un modèle de simulation.
- Publier l’incertitude avec le résultat : un chiffre isolé ne suffit pas comme conclusion.
Pour aller plus loin
Le pilier simulation de flux situe ces usages dans l’ensemble des méthodes, et la définition d’un modèle de simulation en pose les notions de base. La page caler les paramètres par machine learning détaille le problème inverse, tandis que la fiche machine learning appliqué à la simulation couvre le sens direct des métamodèles. Le jumeau numérique est l’un des usages qui s’appuient sur cette vitesse de calcul.
Citer cette page
Simulation de flux — OPTIFLUX SAS. « L'IA dans la simulation de flux ». Mis à jour le 4 novembre 2026. https://www.simulation-de-flux.com/comprendre-la-simulation-de-flux/simulation-et-intelligence-artificielle/
Sources
- Saves et al. — Modèles de substitution et XAI pour explorer des simulations (arXiv, 2025) — consulté le
- Huster et al. — Métamodélisation d’un modèle de simulation à événements discrets (Annals of Operations Research, 2026) — consulté le
- Hao et al. — Modèles de substitution empilés et apprentissage actif validés par simulation (Informatica, 2026) — consulté le
- Wikipédia — Optimisation (mathématiques) — consulté le
- Wikipédia — Calibration de modèle — consulté le
- Wikipédia — Analyse de sensibilité — consulté le